HỒ SƠ BẰNG CHỨNG — Chữ và ngôn ngữ Iberia cổ
Rà soát nguồn cốt lõi 2026-08-22. Hồ sơ tách việc đọc dấu thành âm khỏi việc hiểu ngôn ngữ và dịch nội dung.
Tóm tắt
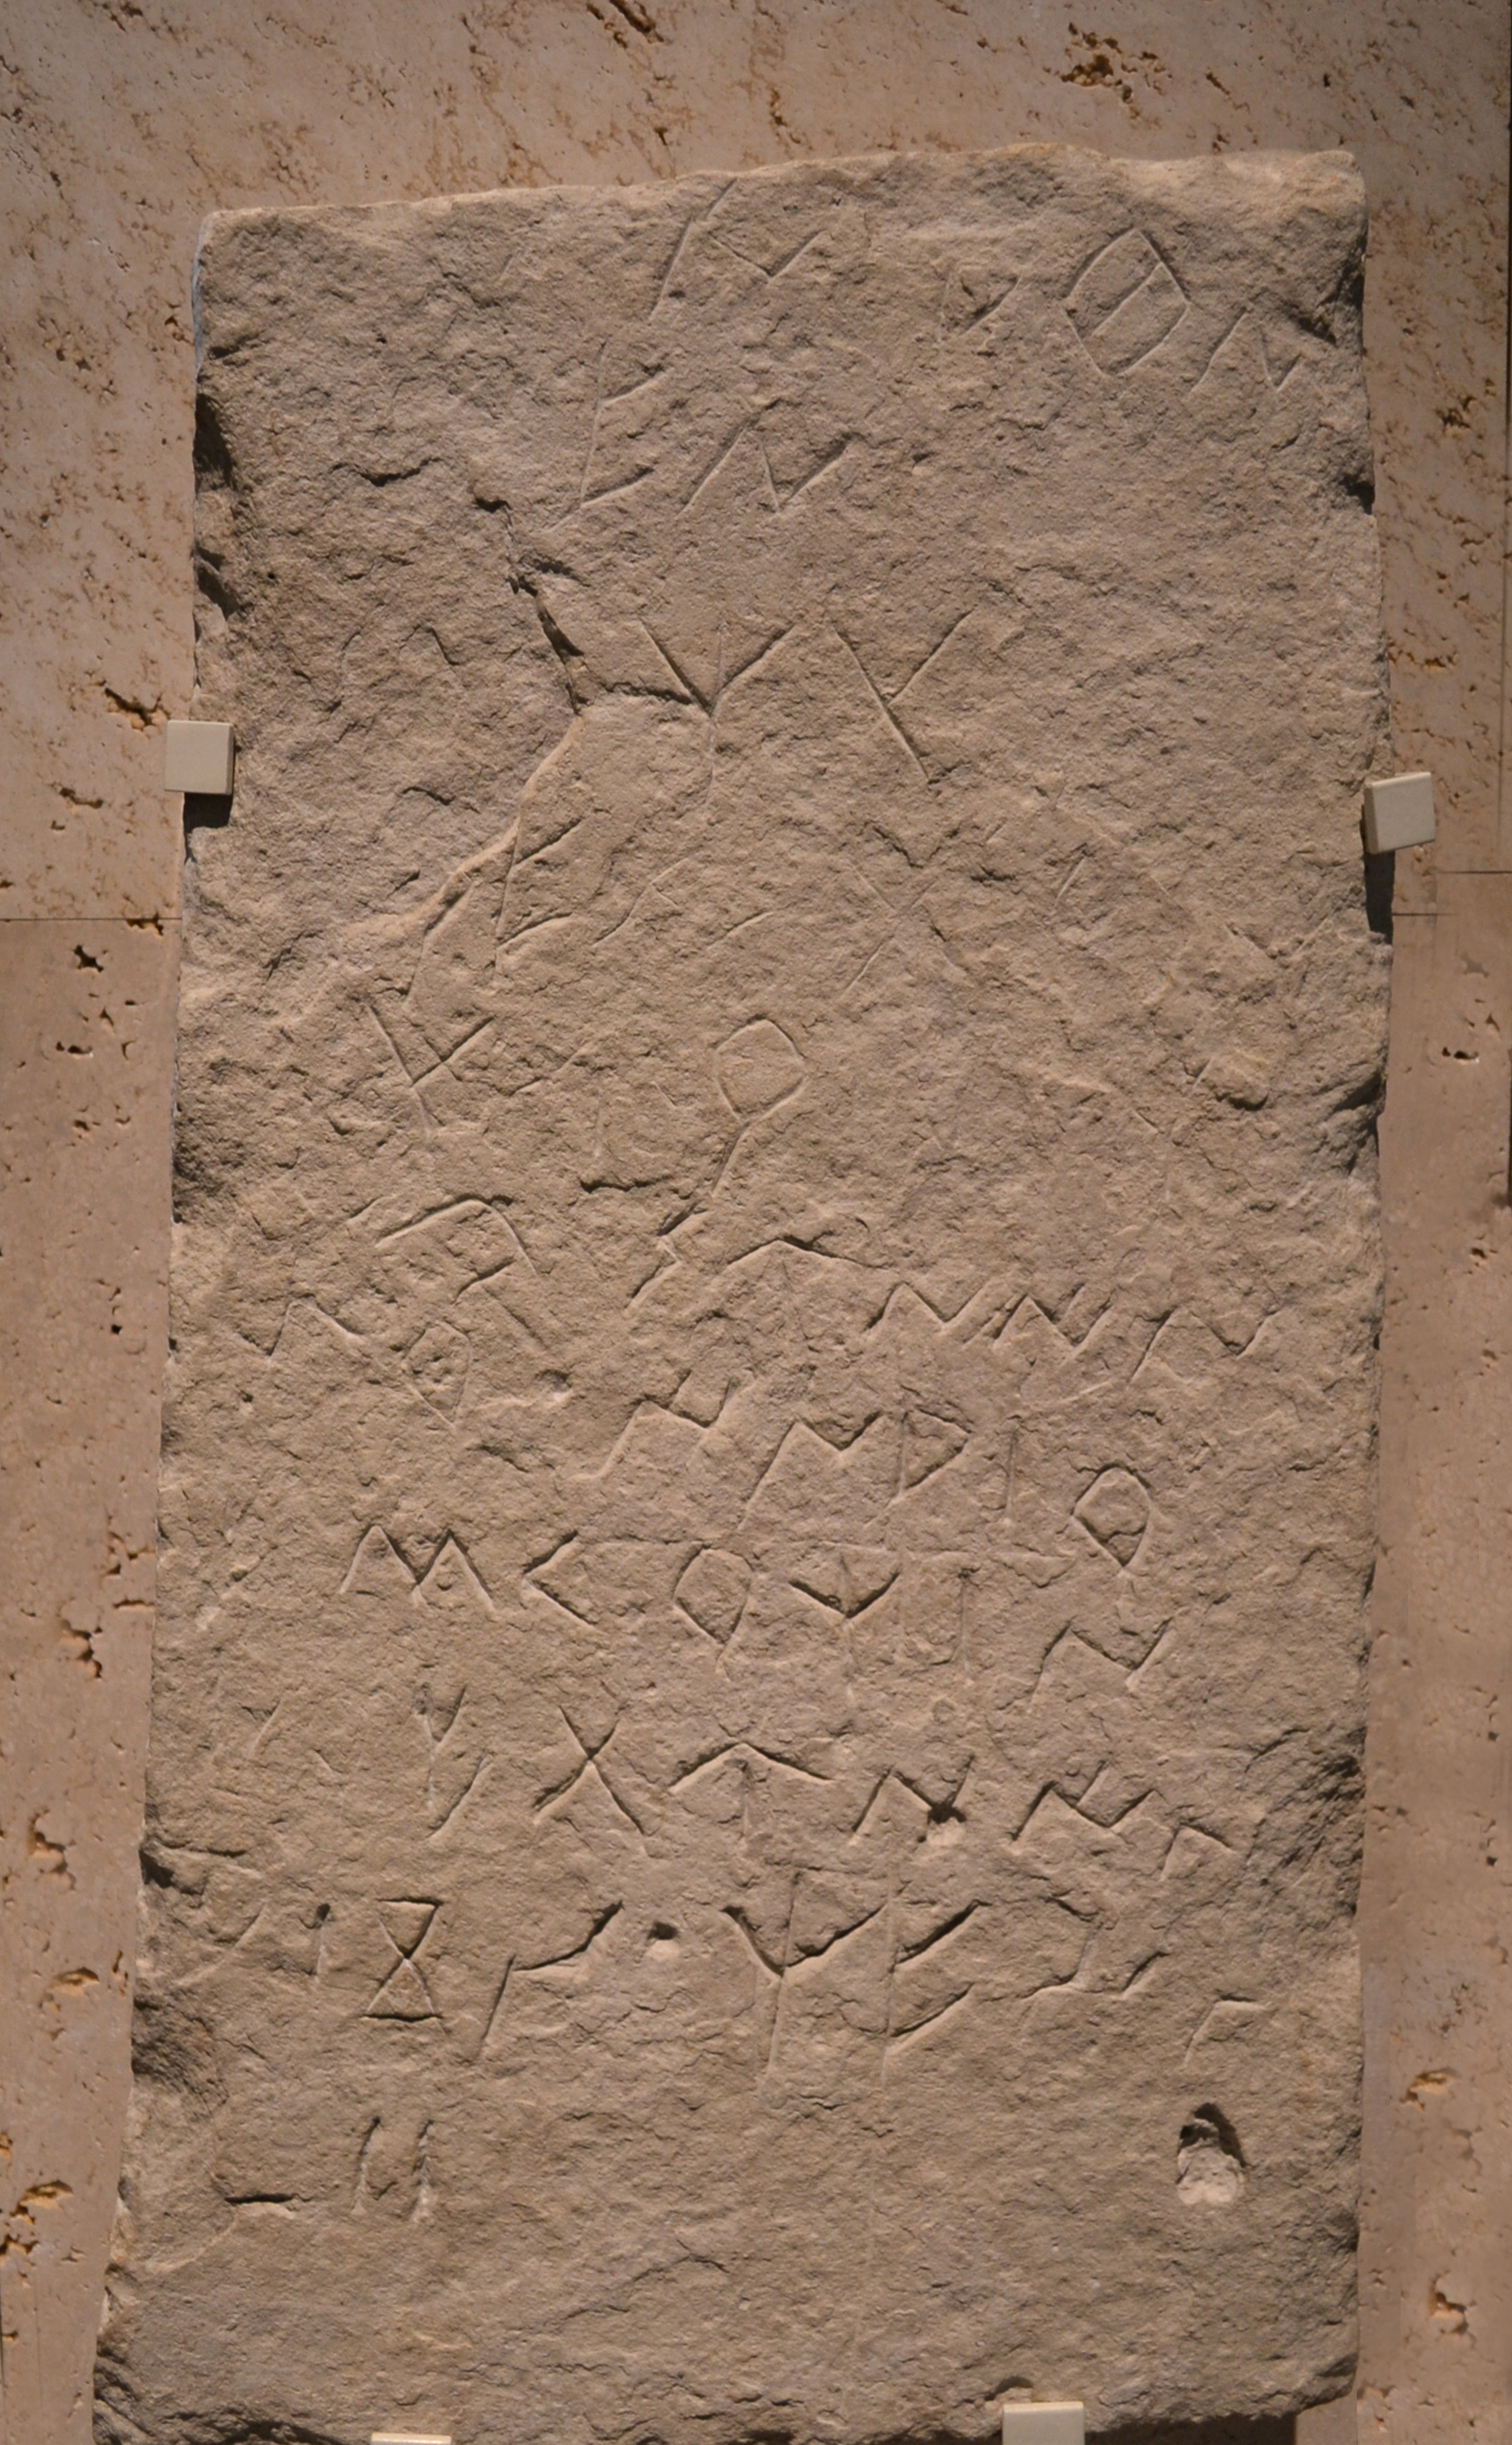
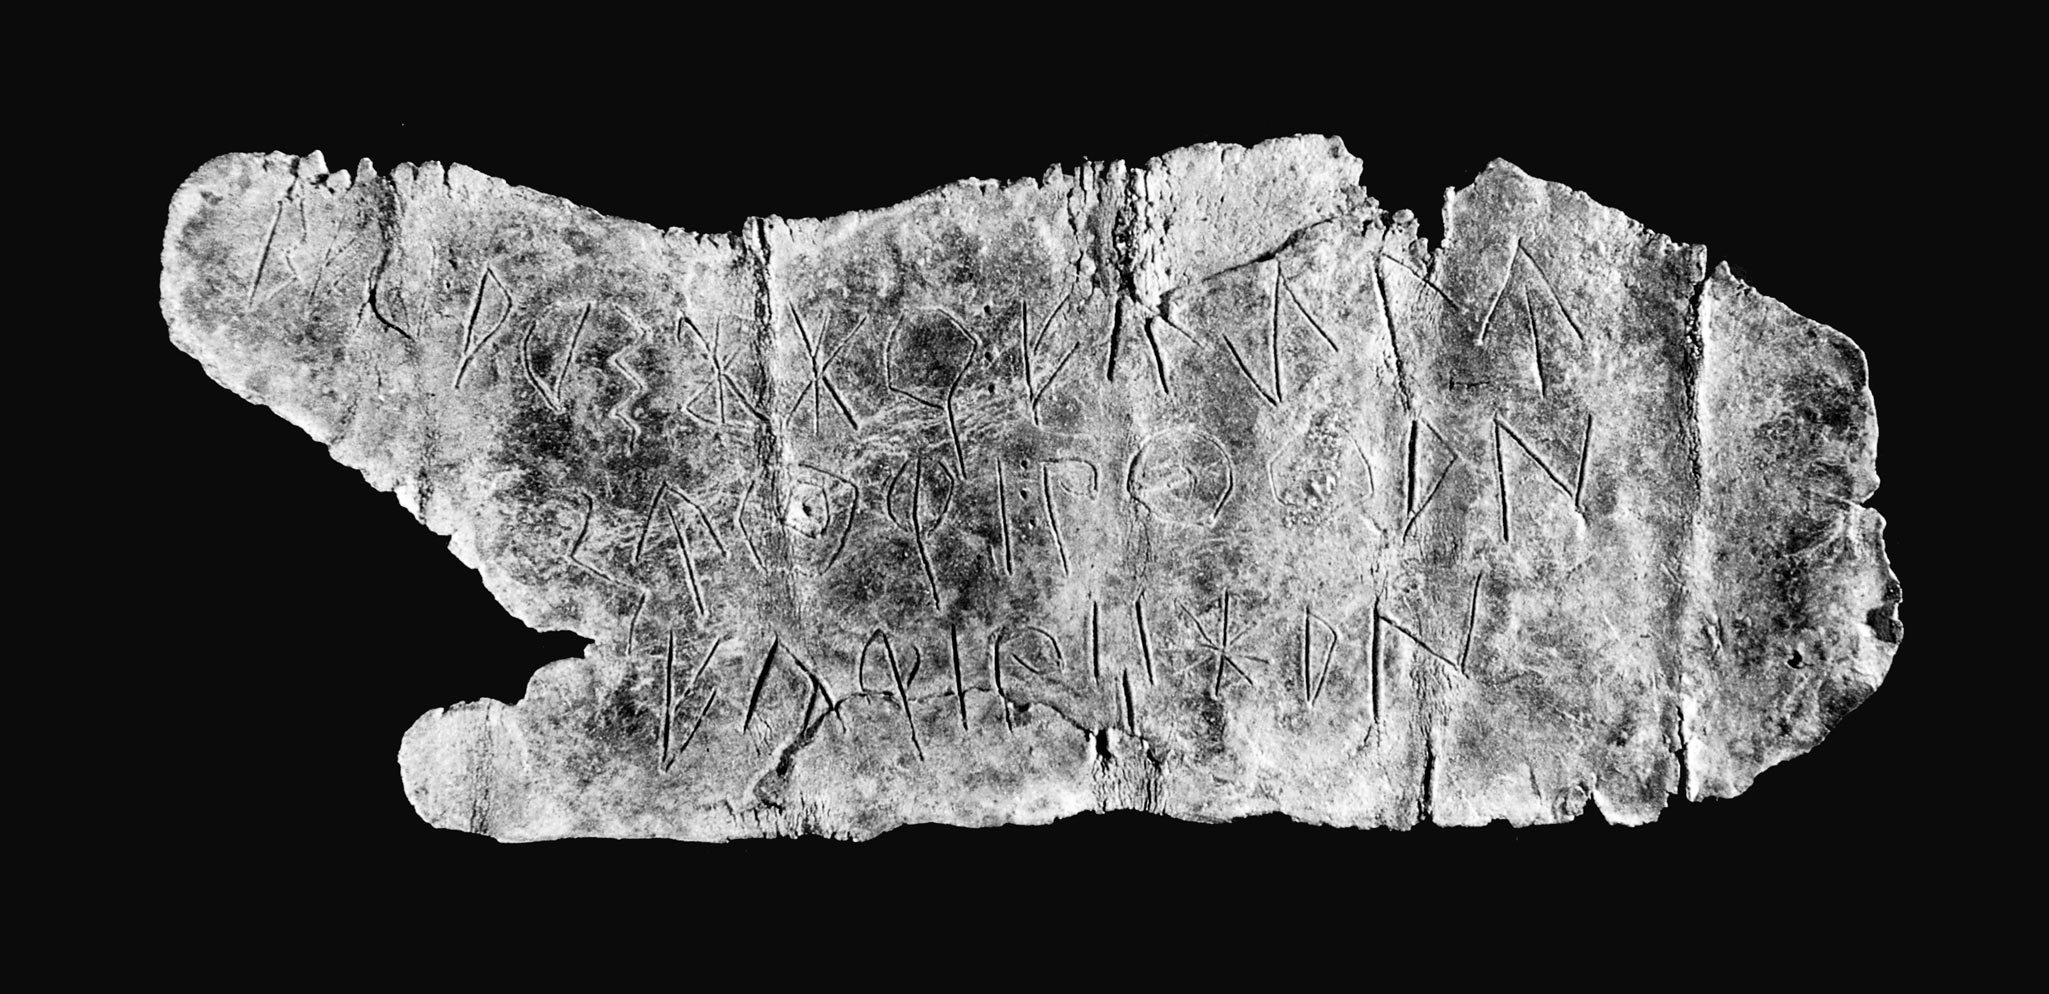
Tiếng Iberia được ghi trên khoảng 2.300 văn khắc từ cuối thế kỷ V TCN đến thời Augustus, phân bố dọc bờ Địa Trung Hải từ sông Hérault ở nam Pháp đến Almería, với mật độ sâu vào thung lũng Ebro. Phần lớn corpus dùng chữ Iberia đông-bắc; ngoài ra còn chữ đông-nam và bảng chữ cái Hy Lạp–Iberia. Manuel Gómez-Moreno nhận ra cấu trúc bán âm tiết và đọc phần lớn giá trị dấu vào đầu thế kỷ XX. Vì vậy có thể chuyển tự nhiều văn bản, nhận diện tên riêng, hậu tố và một số công thức. Tuy nhiên thiếu song ngữ dài, không có họ hàng gần đã hiểu chắc chắn, phân đoạn từ không ổn định và nghĩa của văn bản dài phần lớn vẫn bất khả thấu.
Phán quyết: 🟢 hiện vật, corpus, niên đại và phần lớn khóa đọc đông-bắc; 🟡 một số từ/cấu trúc theo ngữ cảnh và khóa chữ đông-nam; 🔵 bản dịch trọn văn bản, quan hệ di truyền với Basque/Aquitanian và mọi tuyên bố “đã giải mã hoàn toàn”.
Bốn trục xác minh
| Trục | Kết quả | Mức |
|---|
| ⏳ Thời gian | Cuối thế kỷ V TCN đến thời Augustus; một số ví dụ riêng lẻ còn trong thế kỷ I CN. | 🟢/🟡 |
| 📍 Địa điểm | Hérault–Almería và thung lũng Ebro; Castellet de Bernabé là một site có hiện vật minh họa, không đại diện toàn corpus. | 🟢 |
| 👤 Con người | Người viết cổ đại hầu hết vô danh; Gómez-Moreno giải cấu trúc; Untermann hệ thống hóa corpus; Moncunill và Velaza tổng hợp hiện trạng. | 🟢 |
| 🏺 Vật thể | Văn khắc trên chì, tiền, gốm, đá và nhiều vật mang khác; khoảng 2.300 bản là snapshot học thuật, không phải tổng vĩnh viễn. | 🟢/🟡 |
Ba hệ chữ chính
| Hệ | Tình trạng đọc | Ghi chú |
|---|
| Iberia đông-bắc | Gần như/hoàn toàn đọc được ở cấp dấu | Khoảng 2.000 văn bản; bán âm tiết; có biến thể dual và non-dual. |
| Iberia đông-nam | Đọc một phần | Khoảng 70 văn bản theo tổng quan 2020; một số dấu chưa biết giá trị; thường viết phải-sang-trái. |
| Hy Lạp–Iberia | Giá trị chữ cái rõ hơn | Thích nghi bảng chữ cái Hy Lạp Ionian để ghi tiếng Iberia; corpus nhỏ, không tự tạo ra nghĩa từ vựng. |
Trong bán âm tiết, nguyên âm và phụ âm liên tục dùng dấu kiểu chữ cái, còn âm tắc dùng dấu âm tiết. Ở hệ dual đông-bắc, nét phụ phân biệt âm tắc vô thanh/hữu thanh cho nhóm răng và ngạc mềm; biến thể muộn non-dual mất đối lập này. Mã hóa dấu hoặc chuyển tự Latin không đồng nghĩa đã hiểu câu.
Chuỗi suy luận hợp lệ
ảnh/vết khắc → nhận dạng dấu → biến thể/allograph → chuyển tự âm
              → phân đoạn chuỗi → hình thái/tên riêng → diễn giải thể loại
              → bản dịch (hiện chỉ rất hạn chế)
Mỗi mũi tên có độ bất định riêng. Tên cá nhân và địa danh có neo từ tiền, nguồn Latin/Greek và mẫu đặt tên; các từ như eban, seltar, iltiŕ, aŕs vẫn phải ghi là nghĩa đề xuất theo ngữ cảnh, không phải từ điển đã khóa.
Mệnh đề và phản biện
| Mệnh đề | Nhãn | Đánh giá |
|---|
| Có thể đọc thành âm phần lớn văn bản đông-bắc | 🟢 | Khóa bán âm tiết đã được tinh chỉnh từ Gómez-Moreno; còn vấn đề chi tiết/allograph. |
| Đọc được dấu nghĩa là dịch được văn bản | 🔵 | Sai phương pháp: ngữ âm không cung cấp tự động từ vựng và cú pháp. |
| Toàn bộ “chữ Iberia” có một mức giải mã duy nhất | 🔵 | Đông-bắc, đông-nam và Hy Lạp–Iberia có trạng thái tri thức khác nhau. |
| Một số tên riêng, hậu tố và công thức có thể nhận diện | 🟡 mạnh | Có lặp corpus và đối chiếu onomastic; nghĩa câu quanh chúng thường chưa chắc. |
| Tiếng Iberia là ngôn ngữ không Ấn-Âu | 🟢 | Đồng thuận trong tổng quan chuyên ngành; phân loại họ hàng sâu vẫn mở. |
| Tiếng Iberia là tổ tiên trực tiếp của Basque | 🔵 | Tương đồng số từ/onomastic đang được nghiên cứu nhưng chưa đủ làm khóa dịch hay chứng minh phả hệ. |
| Khoảng 2.300 là số corpus cuối cùng | 🟡 | Con số tổng hợp 2020/ấn phẩm 2015; phát hiện và phân loại tiếp tục cập nhật. |
| Có một bản dịch hoàn chỉnh bị che giấu | 🔵 | Không có bằng chứng; hạn chế được công khai trong corpus và nghiên cứu học thuật. |
Provenance, quyền lực và lưu trữ
Văn tự xuất hiện trong giao dịch, sở hữu, tiền tệ, tôn giáo, tang lễ và biểu đạt công cộng; không nên mặc định mọi bản là văn bản nhà nước. Hai phần ba corpus còn lại theo tổng quan 2020 thuộc thế kỷ II–I TCN, khi thực hành chữ viết mở rộng trong bối cảnh chinh phục và Latin hóa. Giới tinh hoa địa phương vừa dùng chữ Iberia trong không gian công cộng vừa dần chuyển sang Latin; đây là biến đổi xã hội có chứng cứ, không phải bằng chứng “xóa lịch sử” hiện đại.
Corpus hiện đại phân tán qua bảo tàng, khai quật và ấn bản. Hesperia liên kết văn khắc, tiền, tên riêng, từ vựng, thư mục và bản đồ; phải giữ mã BDH/MLH/CIG và provenance của từng vật. Không gán danh tính dân tộc hiện đại cho người cổ đại, không dùng giả thuyết Vasco-Iberian để phục vụ tự sự dân tộc chủ nghĩa, và không đánh đồng nơi lưu giữ với nơi tìm thấy.
Cách tự kiểm chứng
- Tra một mục trong Hesperia bằng mã BDH/MLH và ghi vật mang, hướng viết, niên đại, nơi tìm, bảo tàng.
- Đối chiếu ảnh với chuyển tự; giữ dấu mất, dấu nghi vấn và ranh giới từ của ấn bản.
- Xác định hệ đông-bắc, đông-nam hay Hy Lạp–Iberia trước khi áp khóa dấu.
- Tách tên/hậu tố có lặp khỏi nghĩa từ vựng suy đoán; kiểm trên dữ liệu ngoài tập dùng để dựng giả thuyết.
- Không chấp nhận một “bản dịch” nếu không giải thích đều đặn chuỗi dài, biến thể hình thái và văn bản đối chứng.
Nguồn cốt lõi
- Moncunill Martí & Velaza Frías 2020, “Iberian”: https://ifc.dpz.es/recursos/publicaciones/38/77/17moncunillvelaza.pdf
- Ferrer i Jané, Moncunill & Velaza 2015, Unicode/systematization: https://diposit.ub.edu/items/9028187f-dce2-4534-a798-947066d01f7f
- Hesperia Databank: http://hesperia.ucm.es/
- Orduña, Luján & Estarán, mô tả Hesperia: https://doi.org/10.36707/palaeohispanica.v0i9.213
- Iberia Graeca, Castellet de Bernabé: https://bd.iberiagraeca.net/yacimientos/448/reportPDF
Trạng thái: vòng nguồn cốt lõi hoàn tất; cần lập edition-level record cho từng văn khắc trước khi dịch.